Zusammenfassung
- KI-Marktforschung steht und fällt mit der Offenlegung von Datenquellen und Modellierungsansätzen, nicht mit Marketing-Versprechen.
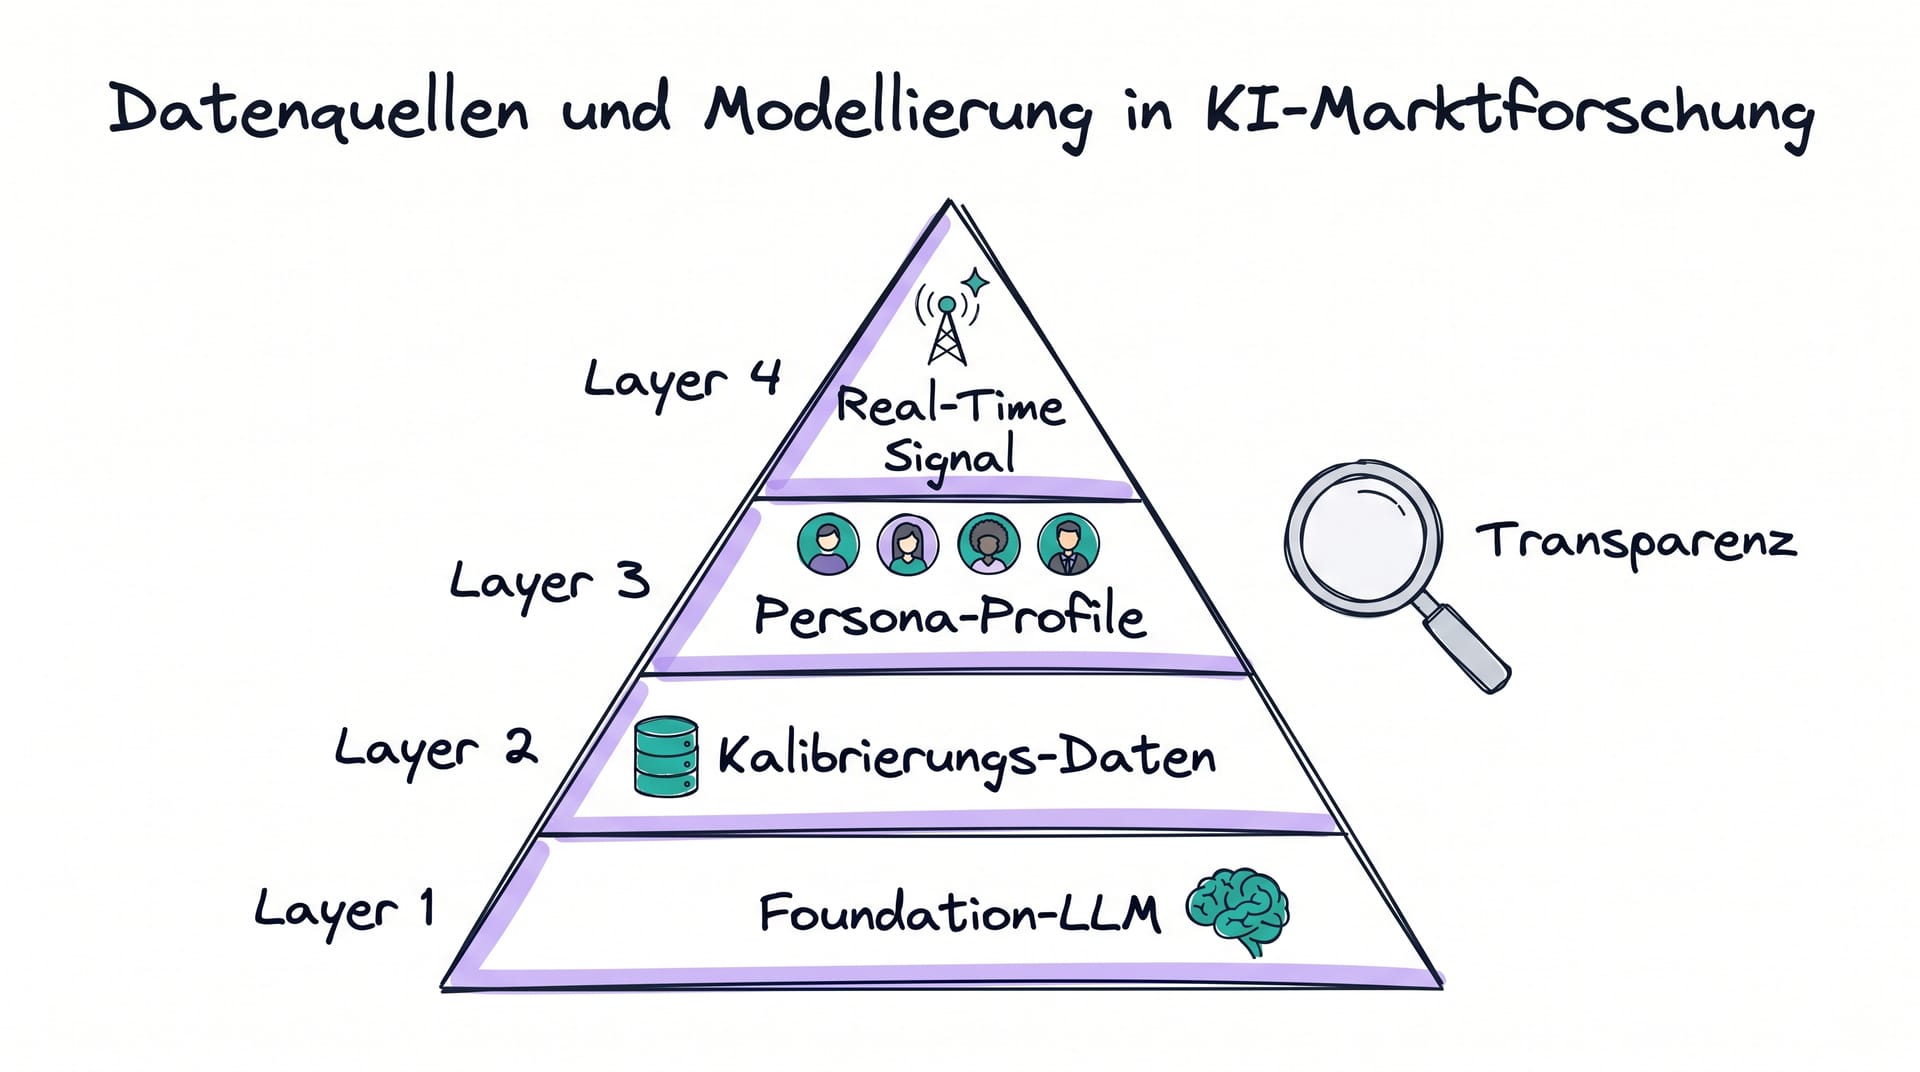
- Es lohnt sich, vier Datenschichten klar zu trennen: Foundation-LLM-Trainingsdaten, Kalibrierungs-Daten der Anbieter, Persona-Profile und optionale Real-time-Signale.
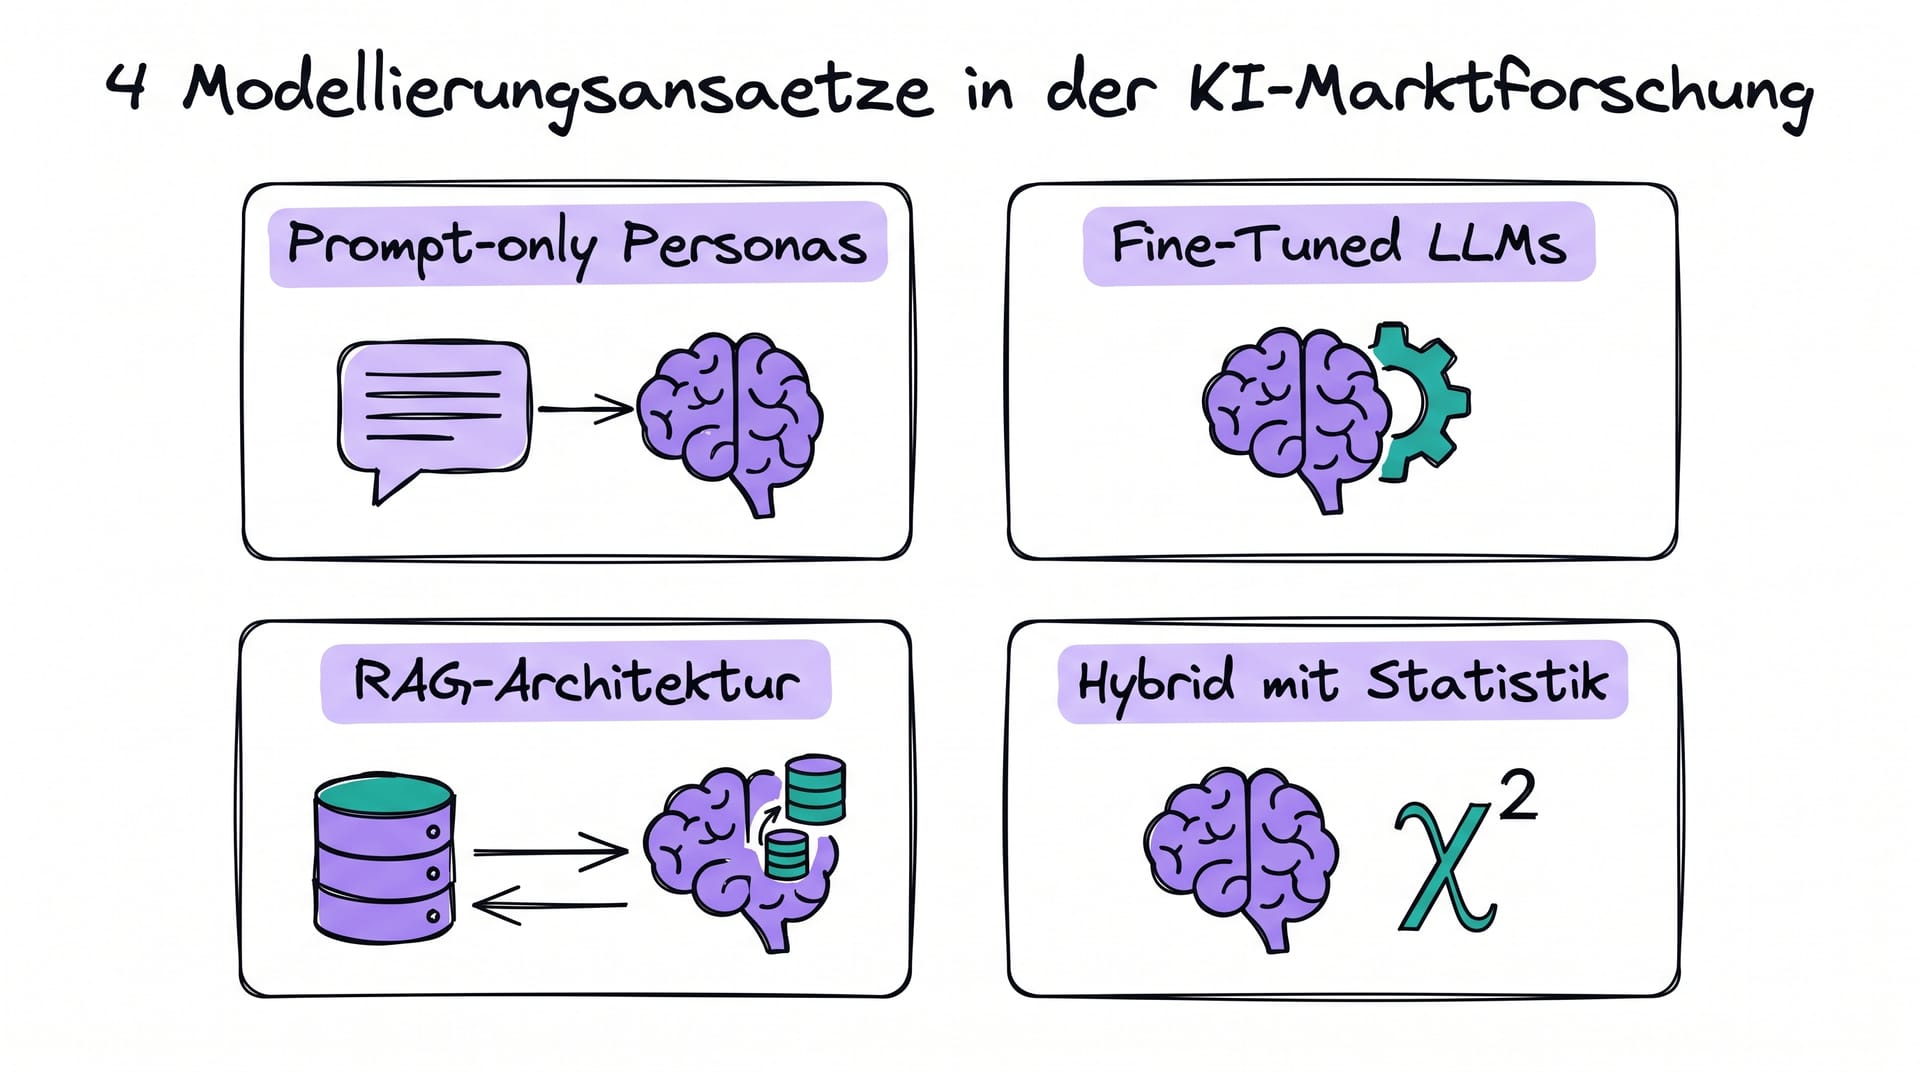
- Die vier dominierenden Modellierungsansätze 2026 sind Prompt-only-Personas, Fine-Tuned LLMs, RAG-Architekturen und Hybrid-Modelle mit klassischer Statistik-Schicht.
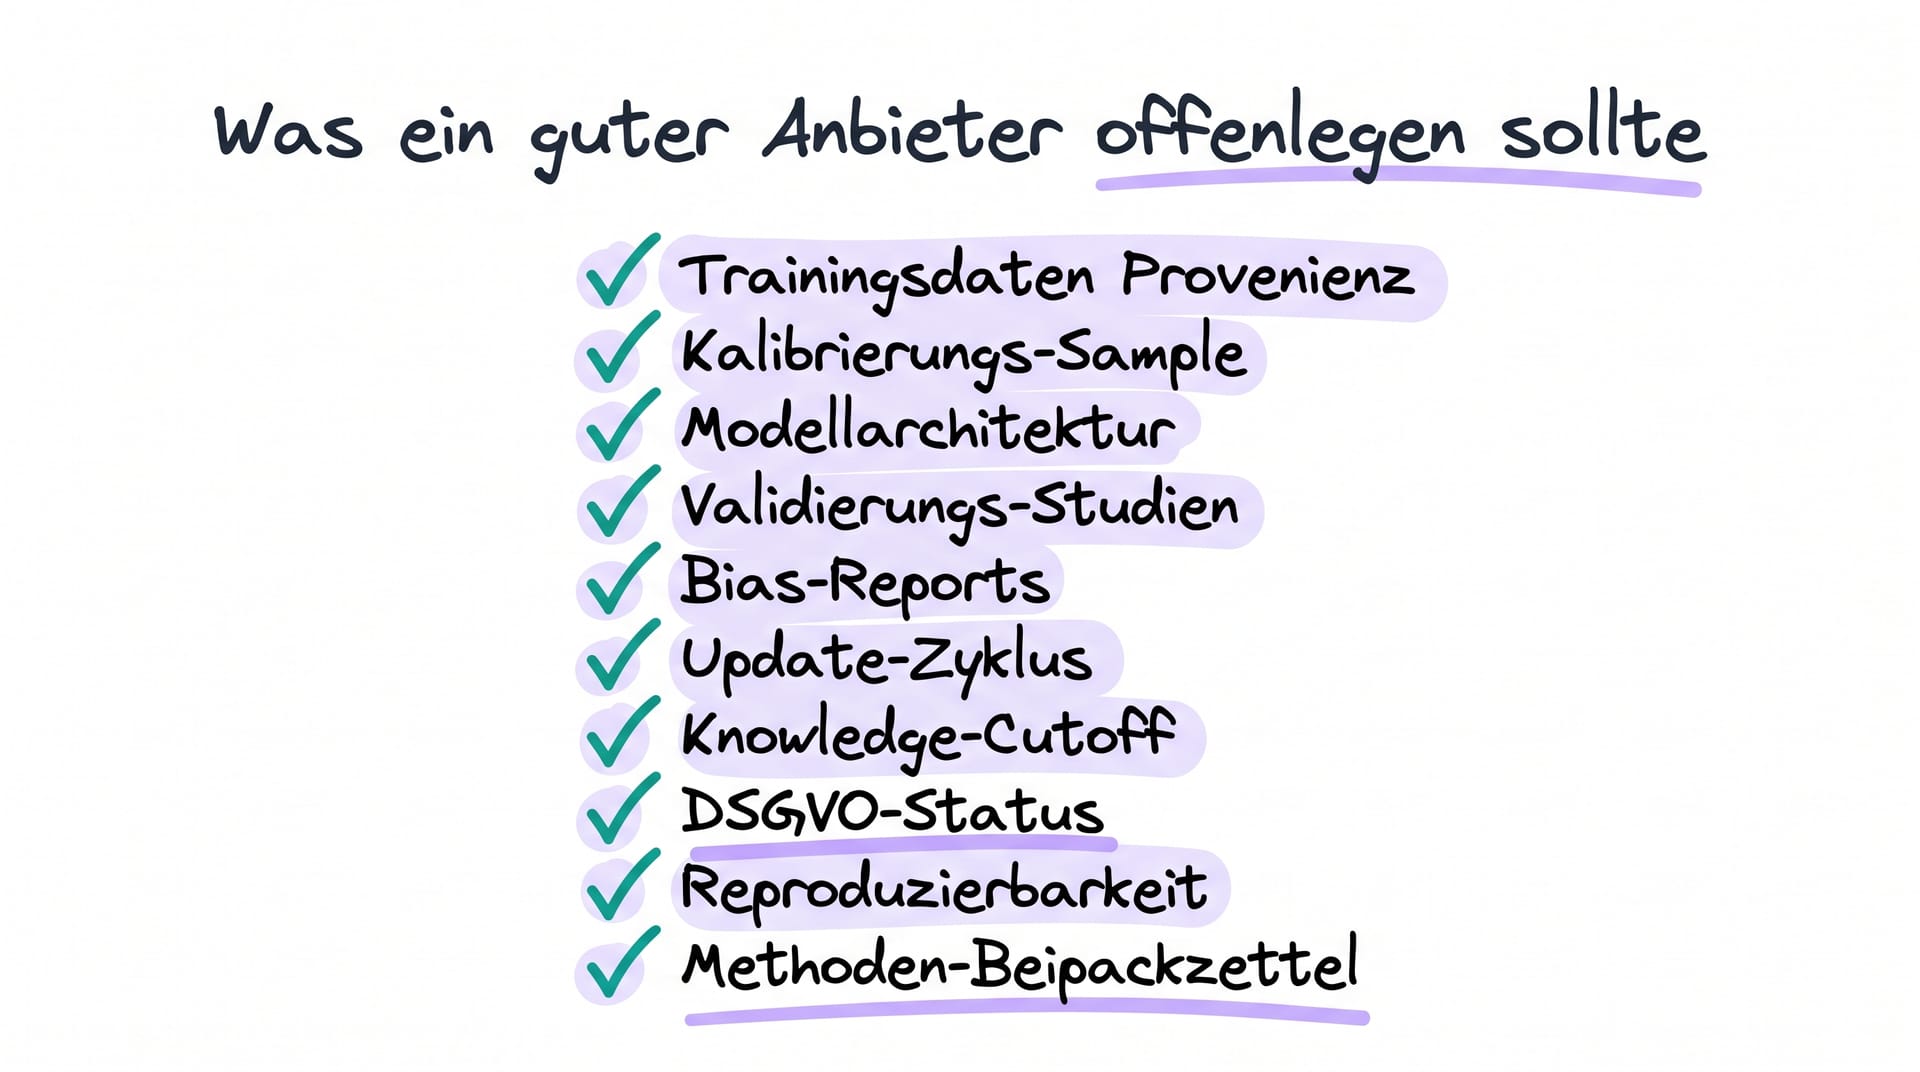
- Ein guter Anbieter offenlegt 8 bis 10 methodische Kernpunkte, von Trainings-Provenienz über Bias-Reports bis zum Knowledge-Cutoff.
- Insights-Heads brauchen ein Vorstands-taugliches 5-Punkte-Methodik-Audit, um Glaubwürdigkeit gegenüber CFO, CMO und Vorstand zu sichern.
- Wer Methodik systematisch dokumentiert, verschiebt die Diskussion von „ist das echt“ zu „wie nutzen wir es strategisch“.
Einleitung
Methodik-Transparenz schlägt Black-Box-Marketing. Das ist die Verschiebung, die 2026 in der KI-Marktforschung sichtbar wird. Noch vor zwei Jahren reichte es, mit „AI-powered Insights“ zu werben. Heute fragen Vorstände zuerst, wie das Modell trainiert wurde, woher die Kalibrierungs-Daten kommen und welche statistischen Garantien der Anbieter geben kann.
Der Grund ist einfach. Insights-Budgets wandern in Richtung synthetischer Panels, gleichzeitig steigen Compliance-Anforderungen durch DSGVO und EU AI Act. Wer eine Investitionsentscheidung über sechs- oder siebenstellige Beträge verteidigen muss, kann sich nicht auf „Trust us“ verlassen. Stakeholder wollen einen Methoden-Beipackzettel, der so klar lesbar ist wie ein Studienprotokoll in der klassischen Marktforschung.
Dieser Artikel erklärt, welche Datenquellen und Modellierungsansätze die Grundlage moderner KI-Marktforschung bilden, welche Transparenz-Standards Anbieter erfüllen sollten und wie ein Methodik-Audit aussieht, das vor dem Vorstand bestand hat. Wer hingegen wissen will, welche Daten man operativ braucht, um eigene Digital Twins zu bauen, findet die Antwort im Schwesterartikel Datenquellen für realistische Digital Twins.
Welche Datenquellen-Schichten gibt es bei KI-Marktforschung?
Eine sauber dokumentierte KI-Marktforschungs-Lösung baut auf mindestens drei, oft vier übereinanderliegenden Datenschichten auf. Wer diese Schichten nicht trennen kann, verkauft eine Black Box.
| Schicht | Inhalt | Beispiel | Transparenz-Standard |
|---|---|---|---|
| 1. Foundation-LLM-Trainingsdaten | Web-Crawls, Bücher, Foren, Code-Repositories bis zum Knowledge-Cutoff | Common Crawl, Wikipedia, Reddit-Snapshots | Modell-Anbieter (OpenAI, Anthropic) muss Cutoff-Datum, Sprachverteilung und grobe Quellenkategorien offenlegen [1] |
| 2. Kalibrierungs-Daten | Reale Panel-Daten, CRM-Auszüge, Statistiken, mit denen der Anbieter das Foundation-Modell anpasst | GfK-Konsumentenpanels, Statistisches Bundesamt, Branchen-Surveys | Sample-Größe, Demografie, Erhebungszeitpunkt, Provider und DSGVO-Status |
| 3. Persona-Profile | Strukturierte Demografie- und Psychografie-Bausteine pro Twin | Alter, Einkommen, Werte (Sinus-Milieus), Mediennutzung | Schema, Quellen pro Feld, Update-Zyklus |
| 4. Real-time Signal-Daten (optional) | Live-Trends, News, Social Listening, die als Kontext eingespielt werden | Google Trends, X-Streams, Markt-News | Update-Frequenz, Filterregeln, Bias-Quellen |
Wichtig ist die saubere Trennung. Das Foundation-Modell wird nicht von Marktforschungs-Anbietern trainiert, sondern lediglich genutzt. Die methodische Verantwortung der Anbieter liegt vor allem in den Schichten 2 bis 4. Wer Schicht 1 als eigenes Asset darstellt, betreibt Etikettenschwindel. Mehr zu klassischen Definitionen findet sich im [AI-Panel Wiki](https://neuroflash.com/de/blog/digital-twin-wiki/ai-panel).
Die vier Modellierungsansätze in der KI-Marktforschung
2026 dominieren vier Modellierungsansätze den Markt. Sie unterscheiden sich erheblich in Aufwand, Reproduzierbarkeit und Tiefenschärfe.
1. Prompt-only-Personas (In-Context). Eine Persona-Beschreibung wird als System-Prompt an ein Standard-LLM geschickt. Schnell, billig, aber stark abhängig von der Prompt-Formulierung und mit hoher Varianz zwischen Läufen. Geeignet für explorative Fragen, problematisch für Reproduzierbarkeit.
2. Fine-Tuned LLMs auf Marktforschungs-Daten. Das Foundation-Modell wird mit echten Survey-Antworten, Interviews und Konsumentendaten nachtrainiert. Höhere Konsistenz, bessere Treffergenauigkeit bei Nischen-Zielgruppen, aber teuer und langsam zu aktualisieren. Risiko des Overfittings auf spezifische Studien.
3. RAG-Architekturen mit externer Wissensbasis. Retrieval-Augmented Generation kombiniert ein Standard-LLM mit einer durchsuchbaren Datenbank aus echten Studien, Statistiken und Konsumentenprofilen. Sehr transparent, weil pro Antwort die abgerufenen Quellen geloggt werden können. Empfohlener Ansatz für regulierte Branchen.
4. Hybrid-Modelle mit klassischer Statistik-Schicht. LLM-Output wird durch ein klassisches statistisches Modell (Bayes, Regression, Conjoint) gewichtet oder kalibriert. Dieser Ansatz verbindet Erklärbarkeit der klassischen Statistik mit der Flexibilität von LLMs und gilt aktuell als Goldstandard für quantitative Schätzungen [2].
Welcher Ansatz der richtige ist, hängt von Use Case und Budget ab. Für strategische Studien gilt: Je näher am Hybrid-Modell, desto besser die Chancen, im Vorstand zu bestehen. Mehr zur Frage, wann welcher Ansatz besser performt als klassische Methoden, im Cluster-Artikel Genauigkeit synthetisch vs traditionell.
Was sollte ein guter Anbieter offenlegen?
Eine Methodik-Transparenz-Checkliste mit zehn Punkten, die Insights-Heads als Mindeststandard einfordern sollten:
- Trainings-Daten Provenienz. Welches Foundation-Modell wird genutzt, wer hat es trainiert, welche groben Quellenkategorien?
- Kalibrierungs-Sample. Größe (n), Demografie, Erhebungsjahr, Datenquelle, DSGVO-Konformität.
- Modellarchitektur. Welcher Ansatz aus dem obigen Quartett, welche Adapter oder Fine-Tuning-Layer, welche Statistikschicht?
- Validierungs-Studien. Externe Benchmark-Vergleiche gegen reale Panels, idealerweise peer-reviewed oder von Drittanbietern auditiert [3].
- Bias-Reports. Welche systematischen Verzerrungen wurden gemessen, welche Korrekturen angewendet? Mehr dazu im Artikel Bias in AI-Marktforschung vermeiden.
- Update-Zyklus. Wie oft werden Kalibrierungs-Daten und Persona-Profile aktualisiert? Quartalsweise ist ein guter Standard.
- Knowledge-Cutoff. Bis zu welchem Datum kennt das Modell die Welt? Kritisch für Trend-Studien.
- DSGVO-Status. Wo werden Daten verarbeitet, wer ist Auftragsverarbeiter, gibt es ein DPIA? Details im Artikel Datenschutz DSGVO synthetische Daten.
- Reproduzierbarkeit-Garantien. Liefert derselbe Prompt heute und in sechs Monaten dieselbe Antwort? Wie wird das technisch sichergestellt (Seed, Snapshot)?
- Methoden-Beipackzettel. Eine ein- bis zweiseitige Zusammenfassung pro Studie, die ohne Tech-Background lesbar ist.
Wer diese zehn Punkte nicht beantworten kann, sollte nicht in einer Vorstandsvorlage auftauchen. Die Anforderungen decken sich weitgehend mit den ESOMAR-Empfehlungen für KI-gestützte Forschung, siehe ESOMAR Standards AI-Marktforschung.
Vorstands-tauglicher Methodik-Audit: 5-Punkte-Framework
Insights-Heads brauchen ein einfaches Format, das sie ihrem Vorstand vorlegen können. Das folgende 5-Punkte-Framework hat sich in mehreren DACH-Konzernen bewährt:
- Datenherkunft in einem Satz. „Unser Anbieter nutzt ein Foundation-LLM von X, kalibriert auf einem Panel von n=12.000 DACH-Konsumenten aus 2025, ergänzt durch Sinus-Milieu-Daten.“
- Modellansatz in einem Satz. „Es kommt ein Hybrid-Modell mit Bayes-Gewichtung zum Einsatz, validiert gegen drei reale Studien mit einer Korrelation von r=0.86.“
- Bias- und Repräsentativitäts-Status. Verweis auf den Bias-Report des Anbieters plus eine eigene Plausibilitätsprüfung. Methodik im Pillar Repräsentativität bei AI-generierten Marktforschungspanels.
- Reproduzierbarkeit und Update-Garantie. „Ergebnisse sind via Seed reproduzierbar, Kalibrierungs-Daten werden Q4/2026 aktualisiert.“
- Restrisiken und Gegenmaßnahmen. Drei bis fünf Punkte, was die Methode nicht leisten kann (z. B. Vorhersage radikaler Marktbrüche), und welche klassischen Methoden flankierend genutzt werden.
Dieses Format passt auf eine Folie. Genau das ist der Zweck. Mehr zur Stakeholder-Kommunikation im Cross-Cluster-Artikel Stakeholder von AI-Marktforschung überzeugen.
Wie sich Anbieter unterscheiden: Transparenz im Markt
Die Transparenz-Praxis 2026 ist heterogen. Einige Anbieter veröffentlichen vollständige Methoden-Reports, andere verstecken sich hinter „proprietary methodology“. Drei grobe Cluster lassen sich beobachten.
Voll transparent. Anbieter veröffentlichen Whitepaper mit Sample-Größen, Validierungs-Studien und Bias-Metriken, vergleichbar zu System Cards der LLM-Anbieter. Sie nennen das genutzte Foundation-Modell, dokumentieren Update-Zyklen und stellen Methoden-Beipackzettel pro Studie bereit.
Teiltransparent. Es gibt grobe Methoden-Beschreibungen auf der Website, aber keine konkreten Zahlen zu Kalibrierungs-Samples oder Validierungs-Ergebnissen. Auf Nachfrage werden Details unter NDA geteilt.
Black Box. Werbung mit „AI-powered“ und „proprietary algorithms“, ohne dass auch grundlegende Fragen (welches LLM, welche Daten) beantwortet werden. Diese Anbieter sollten für strategische Entscheidungen ausgeschlossen werden.
Eine vergleichende Übersicht spezifischer Anbieter findet sich im Artikel Anbieter AI-gestützter Marktforschung im Vergleich.
Praxisbeispiel: Wie eine DACH-Brand ihren Anbieter auditiert hat
Ein Konsumgüter-Konzern aus Süddeutschland (Umsatz > 4 Mrd. Euro) plante 2025 die Migration von 30 Prozent seiner Konsumenten-Insights auf synthetische Panels. Der CFO forderte einen Methodik-Audit, bevor das Budget freigegeben wurde.
Die Insights-Abteilung schickte allen sechs in Frage kommenden Anbietern eine standardisierte Anfrage mit den oben genannten zehn Transparenz-Punkten. Vier antworteten innerhalb einer Woche mit konkreten Zahlen, zwei lieferten nur Marketing-Material. Diese beiden wurden direkt aussortiert.
Bei den verbleibenden vier wurde eine Validierungs-Studie aufgesetzt: Eine bestehende reale Studie mit n=2.400 wurde gegen die synthetischen Panels gespiegelt. Korrelationen lagen zwischen r=0.71 und r=0.89. Der Anbieter mit der höchsten Korrelation hatte zugleich den transparentesten Methoden-Report. Das Audit lag schließlich auf zwei Folien beim Vorstand und wurde in 20 Minuten freigegeben. Mehr zum methodischen Vorgehen bei solchen Spiegelstudien im Artikel Abgleich synthetisch real Best Practices.
Häufige Transparenz-Fehler bei Anbietern
Vier wiederkehrende Muster sind in Audit-Gesprächen 2025 und 2026 aufgefallen:
- „Proprietary“-Vorhang. Methodik wird als Geschäftsgeheimnis deklariert. Wer keine Sample-Größen nennen kann, hat sie meist nicht.
- Vermischung von Schichten. Foundation-Trainingsdaten werden als eigenes Asset präsentiert („wir haben auf Milliarden Datenpunkten trainiert“), obwohl das LLM eingekauft ist.
- Fehlende Validierung. Keine Spiegel-Studie gegen reale Daten, nur anekdotische Erfolgsgeschichten.
- Veraltete Kalibrierung. Kalibrierungs-Daten von 2022, kombiniert mit Aussagen über 2026er Konsumenten-Trends. Die Lücke wird selten offengelegt.
- Statistische Scheinpräzision. Konfidenzintervalle werden auf zwei Nachkommastellen ausgewiesen, ohne dass die zugrundeliegende statistische Methode erklärt wird. Mehr dazu im Artikel Statistische Signifikanz bei Synthetic Panels.
Tools mit transparenter Methodik
Eine kleine Auswahl von Anbietern, die 2026 öffentlich Methoden-Reports oder vergleichbare Dokumente bereitstellen:
- neuroflash. Stellt Methoden-Beipackzettel pro Studie bereit, dokumentiert Kalibrierungs-Sample und nutzt einen Hybrid-Ansatz mit klassischer Statistik-Schicht. Update-Zyklus quartalsweise. Mehr Details im Pillar Repräsentativität bei AI-generierten Marktforschungspanels.
- Yabble. Veröffentlicht Vergleichsstudien gegen reale Panels mit konkreten Korrelations-Metriken.
- Quester (Conversational AI). Dokumentiert seine RAG-Architektur und stellt Bias-Reports auf Anfrage bereit.
- Fairgen. Setzt auf statistische Augmentation realer Panels und veröffentlicht Methoden-Whitepaper.
- Quantilope. Kombiniert klassische Conjoint-Methoden mit AI-Layer und legt die statistische Grundlage offen.
Bei der Auswahl sollten neben dem Methoden-Report immer auch ethische und datenschutzrechtliche Aspekte geprüft werden, siehe Ethik und Datenschutz bei synthetischen Daten und der Artikel zu methodischen Grenzen von Digital Twins.
Mit neuroflash schneller zu validen Insights

neuroflash liefert KI-gestützte Marktforschung mit synthetischen Zielgruppen und Digital Twins für den deutschsprachigen Markt. Insights in Stunden statt Wochen, kalibriert auf realen Befragungs- und Verhaltensdaten und nahtlos integriert in Brand-, Copy- und Performance-Workflows. Jetzt kostenlos testen und in der nächsten Sprint-Woche die ersten Persona-getriebenen Insights gewinnen.
FAQ
Muss mein Anbieter mir wirklich das Foundation-Modell nennen?
Ja. Ohne diese Information lassen sich Knowledge-Cutoff, Sprach-Bias und grundlegende Verhaltensmuster des Modells nicht beurteilen. Seriöse Anbieter nennen das Modell offen.
Was ist der Unterschied zwischen Trainingsdaten und Kalibrierungs-Daten?
Trainingsdaten sind das, womit das Foundation-LLM gebaut wurde, meist Web-Crawls und öffentliche Texte. Kalibrierungs-Daten sind reale Marktforschungs- und Konsumentendaten, mit denen der Anbieter das Modell auf seine Zielgruppe anpasst.
Wie oft sollten Kalibrierungs-Daten aktualisiert werden?
Mindestens jährlich, in volatilen Branchen (FMCG, Fashion, Tech) quartalsweise. Bei wichtigen Marktereignissen ad hoc.
Was ist ein Methoden-Beipackzettel?
Eine ein- bis zweiseitige Zusammenfassung pro Studie, in der Datenquellen, Modellansatz, Sample-Größe, Validierungs-Status und Restrisiken in nicht-technischer Sprache dokumentiert sind. Standard in der Pharma-Forschung, zunehmend auch in der KI-Marktforschung gefordert.
Fazit
Die Zeit der Black Box ist vorbei. Wer 2026 KI-Marktforschung in Vorstandsentscheidungen einfließen lassen will, braucht ein klares, transparent dokumentiertes Methoden-Set. Die saubere Trennung der vier Datenschichten, ein passender Modellierungsansatz, eine Zehn-Punkte-Transparenz-Checkliste und ein Vorstands-taugliches 5-Punkte-Audit-Framework sind das Fundament. Anbieter, die diese Standards erfüllen, gewinnen die Aufträge. Insights-Heads, die diese Standards einfordern, gewinnen die Glaubwürdigkeit ihrer Stakeholder.
Quellenverzeichnis
[1] Anthropic (2025): „Claude 3.5 Model Card.“ https://www.anthropic.com/model-card
[2] Stanford CRFM (2024): „Holistic Evaluation of Language Models (HELM).“ https://crfm.stanford.edu/helm
[3] OpenAI (2024): „GPT-4 System Card.“ https://cdn.openai.com/papers/gpt-4-system-card.pdf
[4] ESOMAR (2024): „Guidelines on AI in Market, Opinion and Social Research.“ https://esomar.org/guidelines
[5] NIQ (2024): „The State of Synthetic Data in Consumer Insights.“ https://nielseniq.com/global/en/insights/report/
[6] Quirks Media (2025): „AI in Market Research: Adoption Survey.“ https://www.quirks.com/articles
[7] Forrester (2024): „The Future of Insights: Synthetic Audiences and Trust.“ https://www.forrester.com/research
[8] McKinsey & Company (2025): „Generative AI in Consumer Research: Opportunities and Risks.“ https://www.mckinsey.com/insights
[9] marktforschung.de (2025): „Transparenz-Standards in der KI-gestützten Marktforschung.“ https://www.marktforschung.de
[10] Boston Consulting Group (2024): „Building Trust in AI-Powered Insights.“ https://www.bcg.com/publications